Resample nến 1 phút VN30F1M sang 5 phút, 15 phút và nến ngày bằng pandas
Duy Nguyen · · Backtest & giao dịch thuật toán
> Tóm tắt nhanh: Để gộp nến 1 phút VN30F1M đúng, nên dùng groupby theo mốc thời gian đã làm tròn thay vì resample, vì resample khung 5 phút sinh ra 718.998 dòng rỗng qua đêm và giờ nghỉ. Cần gán nến lẻ 11:30, 14:30 về nến liền trước, tách nến ATC, kiểm tra đủ 48 nến 5 phút mỗi phiên và bỏ lợi nhuận ngày trên ngày roll và ngày đổi nguồn dữ liệu.
Gần như ai làm backtest VN30F1M cũng bắt đầu từ dữ liệu nến 1 phút, rồi gộp lên khung 5 phút, 15 phút hoặc nến ngày. Trong pandas, việc này tưởng chỉ cần một dòng df.resample("15min"). Thực tế dòng đó sinh ra hàng trăm nghìn nến rỗng qua đêm và giờ nghỉ trưa, chép các lệnh khớp lẻ tẻ lúc 11:30 thành nến riêng, và nếu bạn tính lợi nhuận nến ngày một cách ngây thơ thì kết quả còn bị lẫn cả chênh lệch giữa hai hợp đồng vào ngày roll.
Bài này đi từng bước, trên dữ liệu VN30F1M liên tục 1 phút giai đoạn 02/01/2019 đến 08/10/2026 (1.934 phiên, 468.625 nến 1 phút). Mỗi đoạn code đều đã chạy, và mọi con số trong bài là số do script in ra. Bạn cần Python, pandas và một file dữ liệu 1 phút có các cột thời gian, open, high, low, close, volume và mã hợp đồng.
Phiên giao dịch VN30F1M trông như thế nào trong dữ liệu
Trước khi gộp nến, cần biết dữ liệu gốc có những mốc giờ nào. Mỗi nến 1 phút trong file được đánh dấu bằng giờ mở nến (nến 09:00 chứa các lệnh khớp từ 09:00:00 đến 09:00:59). Một phiên VN30F1M có bốn đoạn:
- Phiên sáng 09:00 đến 11:30, khớp lệnh liên tục. Nến đầu tiên 09:00 thường có khối lượng lớn vì chứa lệnh tồn từ đầu phiên.
- Nghỉ trưa 11:30 đến 13:00. Thỉnh thoảng có vài lệnh khớp được ghi vào nến 11:30.
- Phiên chiều 13:00 đến 14:30, khớp lệnh liên tục. Tương tự, đôi khi có nến 14:30 rất nhỏ.
- Phiên ATC (khớp lệnh định kỳ đóng cửa) 14:30 đến 14:45, chỉ có một mức giá khớp duy nhất, được ghi vào nến 14:45.
Như vậy một phiên chuẩn có 150 phút buổi sáng và 90 phút buổi chiều. Gộp theo 15 phút sẽ ra 10 nến sáng và 6 nến chiều, theo 5 phút ra 48 nến. Đây là con số để bạn kiểm tra kết quả của mình về sau.
Bước 1: đọc và làm sạch dữ liệu 1 phút
Dữ liệu được lưu theo giờ UTC, nên việc đầu tiên là đổi sang giờ Việt Nam rồi bỏ múi giờ để thao tác cho gọn. Ngoài ra cần bỏ các dòng trùng thời gian và ngày 19/10/2018, ngày có giá in sai (cách cả hai phiên lân cận hơn 10%, điều không thể xảy ra khi biên độ là ±7%). Bài dùng giai đoạn từ 2019 nên ngày này nằm ngoài, nhưng giữ dòng lọc để code dùng được cho toàn bộ dữ liệu.
import numpy as np
import pandas as pd

PATH = "vn30f1m_1m_2017-08-10_2026-10-08.parquet"
START, END = "2019-01-01", "2026-10-08"

def load_1m(path):
    d = pd.read_parquet(path)
    ts = d["time_bar"].dt.tz_convert("Asia/Ho_Chi_Minh").dt.tz_localize(None)
    cols = ["open", "high", "low", "close"]
    df = pd.DataFrame({c: d[c].astype(float).to_numpy() for c in cols}, index=ts)
    df["volume"] = d["volume"].to_numpy()
    df["ticker"] = d["ticker_id"].astype(str).to_numpy()
    df["source"] = d["source_bars"].astype(str).to_numpy()
    df = df[~df.index.duplicated()].sort_index()
    df = df[df.index.normalize() != pd.Timestamp("2018-10-19")]  # ngày giá in sai
    return df.loc[START:END]

bars = load_1m(PATH)
print(len(bars), bars.index.normalize().nunique())
Cột ticker cho biết nến thuộc hợp đồng nào (chuỗi VN30F1M liên tục ghép nhiều hợp đồng tháng nối nhau). Cột source cho biết nến đến từ nhà cung cấp nào. Hai cột này sẽ cần ở bước 3.
Bước 2: vì sao resample thẳng tay cho kết quả sai
Thử gộp thẳng bars.resample("5min").agg(...) trên dữ liệu trên, script in ra 816.838 dòng, trong đó 718.998 dòng rỗng. Lý do là resample tạo một lưới thời gian đều từ nến đầu đến nến cuối, kể cả ban đêm, cuối tuần, ngày lễ và giờ nghỉ trưa. Với khung 15 phút cũng vậy: 272.280 dòng, 236.287 dòng rỗng. Nếu sau đó bạn gọi ffill() hoặc dropna() không cẩn thận, bạn sẽ có những nến "phẳng" giả tạo hoặc chỉ báo kỹ thuật bị tính trên một lưới thời gian không có thật.
Vấn đề thứ hai nhỏ hơn nhưng khó thấy: các lệnh khớp lẻ lúc 11:30 và 14:30 tạo thành một nến 5 phút riêng với khối lượng rất nhỏ. Trên phần dữ liệu DNSE, trung vị khối lượng của nến 11:30 chỉ là 49 hợp đồng, so với 593,5 hợp đồng ở nến 11:29. Một nến như vậy làm sai số nến mỗi phiên và làm méo các chỉ báo dựa trên khối lượng.
Cách làm đúng gồm hai ý. Thứ nhất, gán các nến lẻ về nến hợp lệ gần nhất trong cùng phiên (11:30 về 11:29, 14:30 về 14:29, vài nến trước 13:00 trong dữ liệu cũ về 13:00) và tách riêng nến ATC. Thứ hai, thay vì resample, dùng groupby trên mốc thời gian đã làm tròn xuống. groupby chỉ tạo nhóm cho những mốc có dữ liệu, nên không có nến rỗng nào sinh ra.
AGG = {"open": "first", "high": "max", "low": "min", "close": "last", "volume": "sum"}

def tag_sessions(df):
    m = df.index.hour * 60 + df.index.minute
    day = df.index.normalize()
    slot = pd.Series(df.index, index=df.index)
    lunch = (m >= 690) & (m < 760)        # lệnh lẻ 11:30 -> nến 11:29
    pre_pm = (m >= 760) & (m < 780)       # trước 13:00 -> nến 13:00
    late = (m >= 870) & (m < 883)         # 14:30 -> nến 14:29
    slot[lunch] = day[lunch] + pd.Timedelta(minutes=689)
    slot[pre_pm] = day[pre_pm] + pd.Timedelta(minutes=780)
    slot[late] = day[late] + pd.Timedelta(minutes=869)
    out = df.copy()
    out["slot"] = slot.to_numpy()
    out["session"] = np.select([m < 760, m < 883], ["sang", "chieu"], "ATC")
    return out

def resample_intraday(df, rule):
    cont = df[df["session"] != "ATC"]            # chỉ phiên khớp liên tục
    return cont.groupby(cont["slot"].dt.floor(rule)).agg(AGG)

dnse = bars[bars["source"] == "dnse"]
vm = dnse.groupby(dnse.index.hour * 60 + dnse.index.minute)["volume"].median()
print("KL trung vị nến 11:29 và 11:30:", vm[689], vm[690])

tagged = tag_sessions(bars)
print("Nến lẻ gán lại:", (tagged["slot"] != tagged.index).sum(),
      "| nến ATC:", (tagged["session"] == "ATC").sum())
for rule in ["5min", "15min"]:
    naive = bars.resample(rule).agg(AGG)
    good = resample_intraday(tagged, rule)
    per_day = good.groupby(good.index.normalize()).size()
    print(rule, len(naive), naive["open"].isna().sum(),
          len(good), per_day.median(), per_day.max())

g15 = resample_intraday(tagged, "15min")
cont_vol = tagged.loc[tagged["session"] != "ATC", "volume"].sum()
print("Khối lượng khớp:", g15["volume"].sum() == cont_vol)
Kết quả: 3.134 nến lẻ được gán lại và 1.928 nến ATC được tách riêng. Khung 5 phút còn 92.779 nến, trung vị và tối đa đều là 48 nến mỗi phiên. Khung 15 phút còn 30.931 nến, đúng 16 nến mỗi phiên ở cả trung vị lẫn tối đa. Dòng kiểm tra cuối in True, tức tổng khối lượng sau khi gộp bằng đúng tổng khối lượng 1 phút của phiên liên tục. Hai phép kiểm tra này (số nến mỗi phiên và tổng khối lượng) nên chạy mỗi lần bạn viết lại hàm gộp nến.
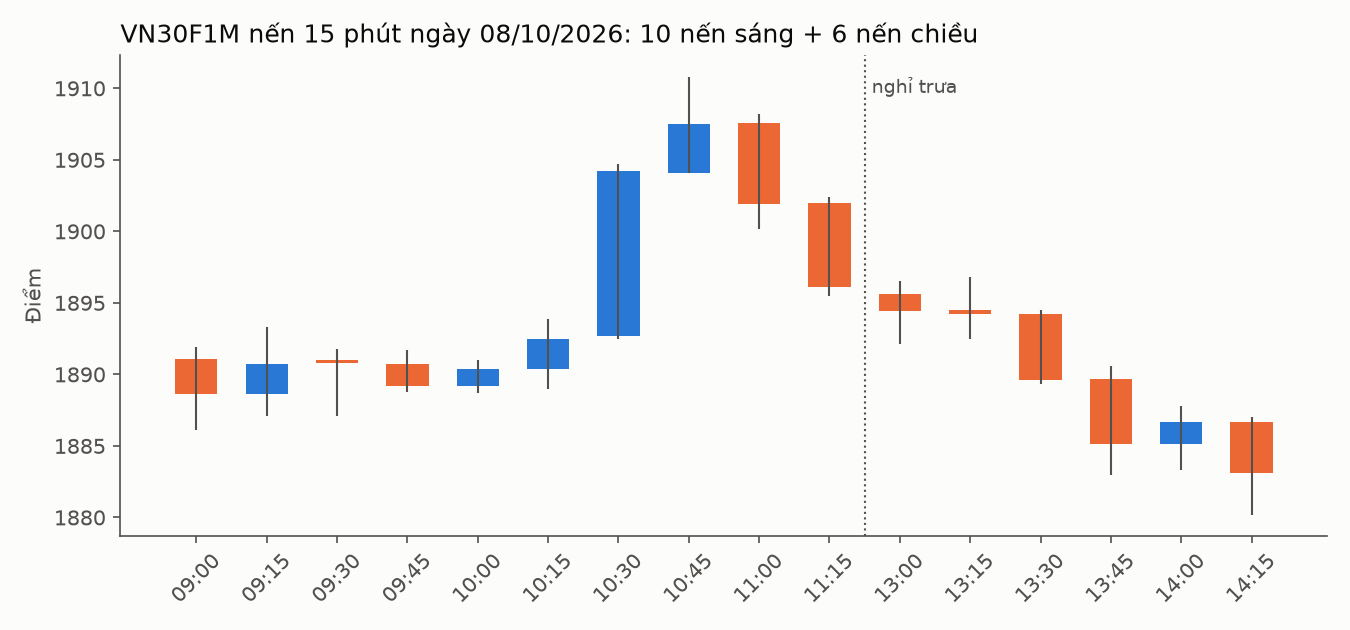
Hình 1: Nến 15 phút của phiên 08/10/2026 sau khi gộp đúng cách. Xanh là nến tăng, cam là nến giảm. Giờ nghỉ trưa không sinh ra nến nào.
Một lưu ý về nhãn thời gian. Hàm trên đặt nhãn mỗi nến bằng giờ mở nến, nên nến "09:00" khung 15 phút chỉ hoàn tất lúc 09:15. Nếu bạn tính tín hiệu trên giá đóng cửa của nến này, lệnh sớm nhất chỉ được khớp ở nến kế tiếp. Ghép tín hiệu khung lớn về khung 1 phút mà quên dịch đi một nến là lỗi nhìn trước tương lai (look-ahead bias) rất phổ biến.
Bước 3: nến ngày, phiên ATC và ngày roll hợp đồng
Nến ngày có vẻ đơn giản nhất nhưng lại có nhiều bẫy nhất. Gộp bằng resample("D") cho 2.837 dòng, trong đó 903 dòng rỗng là cuối tuần và ngày lễ. Gộp theo ngày giao dịch bằng groupby cho đúng 1.934 phiên.
Câu hỏi tiếp theo là giá đóng cửa ngày lấy ở đâu. Giá ATC lúc 14:45 là giá đóng cửa chính thức, dùng để tính lãi lỗ cuối ngày. Script so giá ATC với giá khớp cuối của nến 14:29: hai giá khác nhau ở 94,4% số phiên, chênh lệch tuyệt đối trung bình 2,30 điểm, trung vị 1,40 điểm. Nếu chiến lược của bạn thoát lệnh ở phiên liên tục thì dùng giá 14:29. Nếu thoát bằng lệnh ATC thì phải dùng giá ATC. Trộn hai loại giá trong cùng một backtest sẽ tạo ra lợi nhuận không có thật.
Bẫy lớn nhất là ngày roll. Chuỗi VN30F1M liên tục ghép hợp đồng tháng này với hợp đồng tháng sau. Hợp đồng đáo hạn vào thứ Năm thứ ba của tháng (nếu trùng ngày nghỉ thì lùi về phiên giao dịch liền trước), nên phiên kế tiếp chuỗi giá đã là một hợp đồng khác. Lợi nhuận đóng cửa hôm trước so với đóng cửa hôm nay trên ngày roll lẫn cả chênh lệch giá giữa hai kỳ hạn, không phải biến động thị trường.
Dữ liệu còn có một bẫy riêng: giai đoạn 2017 đến 2023 có những đoạn nến lấy từ nhà cung cấp cũ (legacy), mức giá lệch tới khoảng 50 điểm so với dữ liệu DNSE. Lợi nhuận tính qua ngày đổi nguồn cũng phải bỏ. Lợi nhuận trong cùng một phiên thì không bị ảnh hưởng bởi cả hai vấn đề này.
def third_thursday_expiries(days):
    days = pd.DatetimeIndex(sorted(days))
    out = []
    for p in pd.period_range(days.min(), days.max(), freq="M"):
        first = p.start_time
        thu3 = first + pd.Timedelta(days=(3 - first.dayofweek) % 7 + 14)
        cands = days[(days >= first) & (days <= thu3)]   # lễ -> lùi về phiên trước
        if len(cands) and thu3 <= days.max():
            out.append(cands[-1])
    return pd.DatetimeIndex(out)

def daily_bars(df):
    g = df.groupby(df.index.normalize())
    daily = g.agg(AGG)                                # close = giá ATC nếu có
    cont = df[df["session"] != "ATC"]
    daily["close_1429"] = cont.groupby(cont.index.normalize())["close"].last()
    daily["ticker"] = g["ticker"].last()
    daily["source"] = g["source"].last()
    daily["expiry"] = daily.index.isin(third_thursday_expiries(daily.index))
    daily["roll"] = daily["expiry"].shift(1, fill_value=False)
    daily["switch"] = daily["source"] != daily["source"].shift(1)
    daily.iloc[0, daily.columns.get_loc("switch")] = False
    daily["gap"] = daily["open"] - daily["close"].shift(1)
    bad = daily["roll"] | daily["switch"]
    daily["ret"] = daily["close"].pct_change().where(~bad)   # NaN ở ngày roll/đổi nguồn
    return daily

daily = daily_bars(tagged)
tick_change = daily["ticker"] != daily["ticker"].shift(1)
print("Ngày roll:", daily["roll"].sum(), "| đổi mã đúng ngày roll:",
      (tick_change & daily["roll"]).sum(), "/", tick_change.iloc[1:].sum())
normal = ~daily["roll"] & ~daily["switch"]
for name, mask in [("thường", normal), ("roll", daily["roll"]), ("đổi nguồn", daily["switch"])]:
    gap = daily.loc[mask, "gap"].abs()
    print(name, gap.notna().sum(), round(gap.median(), 1))
Phép kiểm tra quan trọng nhất ở đây là dòng in đầu tiên. Quy tắc thứ Năm thứ ba cho 93 ngày roll trong giai đoạn, và cả 93 lần đổi mã hợp đồng trong dữ liệu đều rơi đúng vào các ngày này. Nếu hai con số không khớp, hoặc lịch đáo hạn của bạn sai, hoặc dữ liệu bị ghép hợp đồng sai chỗ. Script cũng tìm thấy 10 ngày đổi nguồn dữ liệu.
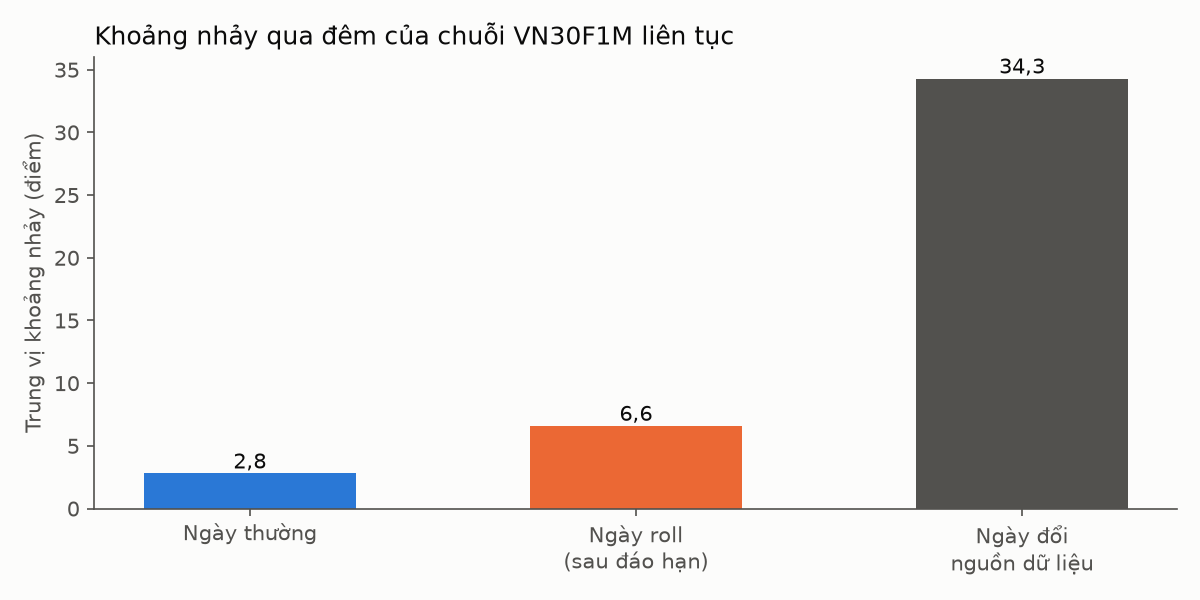
Hình 2: Trung vị khoảng cách giữa giá mở cửa và giá đóng cửa phiên trước, tính bằng điểm, giai đoạn 2019 đến 10/2026.
Hình 2 cho thấy vì sao phải đánh dấu các ngày này. Ở 1.831 ngày thường, khoảng nhảy qua đêm có trung vị 2,8 điểm. Ở 93 ngày roll con số là 6,6 điểm, và ở 10 ngày đổi nguồn là 34,3 điểm. Lợi nhuận ngày thô lớn nhất trên các ngày roll hoặc đổi nguồn là 11,01%, vượt cả biên độ ±7% của hợp đồng, trong khi ở ngày thường mức lớn nhất là 7,00%. Một con số vượt biên độ như vậy chắc chắn là lỗi ghép chuỗi, không phải biến động thật.
Sau khi đặt NaN cho các ngày này (tổng cộng 103 trên 1.934 phiên không có lợi nhuận ngày, tính cả phiên đầu tiên của chuỗi), độ lệch chuẩn lợi nhuận ngày giảm từ 1,491% xuống 1,438%. Mức chênh này nhìn nhỏ, nhưng các ngày bị loại chứa những điểm cực trị như mức 11,01% ở trên, nên chúng ảnh hưởng mạnh tới drawdown, các chỉ số đuôi và những chiến lược giữ lệnh qua đêm.
Những lỗi hay gặp khi gộp nến phái sinh
Từ ba bước trên, có thể rút ra vài nguyên tắc chung khi xử lý dữ liệu VN30F1M:
- Dùng
groupbytheo ngày giao dịch và theo mốc đã làm tròn, không dùng lưới thời gian đều củaresamplerồi lấp chỗ trống. - Kiểm tra số nến mỗi phiên (48 nến 5 phút, 16 nến 15 phút) và tổng khối lượng trước và sau khi gộp.
- Tách nến ATC khỏi phiên liên tục, và chọn rõ giá đóng cửa ngày là ATC hay 14:29 tùy cách chiến lược thoát lệnh.
- Không tính lợi nhuận qua đêm trên ngày roll và ngày đổi nguồn dữ liệu. Chiến lược giữ lệnh qua đêm cần chuỗi đã điều chỉnh chênh lệch kỳ hạn hoặc tính lãi lỗ theo từng hợp đồng.
- Nhớ nhãn nến là giờ mở nến. Tín hiệu từ một nến chỉ dùng được từ nến tiếp theo.
Câu hỏi thường gặp
Có nên dùng resample(..., origin=...) thay cho groupby không? Được, nhưng bạn vẫn phải xóa nến rỗng và vẫn phải xử lý nến lẻ 11:30, 14:30 cùng nến ATC. Với khung 5 và 15 phút, phiên sáng và chiều đều chia hết, nên làm tròn xuống bằng dt.floor cho kết quả gọn và dễ kiểm tra hơn.
Khung 30 phút hoặc 1 giờ thì sao? Khung 30 phút vẫn chia hết hai buổi (5 nến sáng, 3 nến chiều). Khung 1 giờ thì không: buổi sáng 150 phút sẽ có nến 11:00 chỉ dài 30 phút. Khi đó nên quyết định rõ là chấp nhận nến ngắn, hay gộp theo mốc tự định nghĩa như 09:00, 10:00, 11:00 đến 11:30.
Chiến lược giữ lệnh qua đêm thì làm gì với ngày roll? Cách đơn giản nhất là đóng vị thế ở phiên đáo hạn và mở lại ở hợp đồng mới, tính lãi lỗ riêng từng hợp đồng, đồng thời tính cả chi phí của lần roll đó. Không nên lấy chuỗi liên tục thô rồi tính lợi nhuận như một tài sản duy nhất.
Dữ liệu sạch là phần việc ít ai muốn làm nhưng quyết định kết quả backtest nhiều hơn bạn nghĩ. Nếu muốn thử ý tưởng trên khung 5 hoặc 15 phút mà không phải tự viết toàn bộ phần xử lý dữ liệu này, bạn có thể tạo bot và chạy backtest trên nền tảng QuantVN. Để ôn lại các thao tác pandas cơ bản, xem Pandas cho chứng khoán. Để hiểu kỹ hơn diễn biến của phiên đáo hạn, xem bài ngày đáo hạn phái sinh VN30F1M.